Jaka jest różnica między sieciami neuronowymi typu feed-forward a rekurencyjnymi?


Odpowiedzi:


57

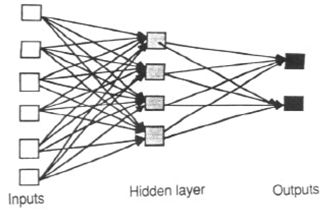
Sprzężenie zwrotne ANN umożliwia przesyłanie sygnałów tylko w jedną stronę: od wejścia do wyjścia. Brak sprzężenia zwrotnego (pętle); tj . wyjście dowolnej warstwy nie wpływa na tę samą warstwę. Informacje zwrotne ANN są zwykle sieciami, które łączą dane wejściowe z wynikami. Są szeroko stosowane w rozpoznawaniu wzorów. Ten typ organizacji jest również określany jako oddolny lub odgórny.

Sieć feed-forward

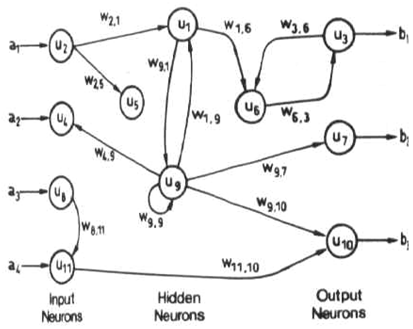
Sieci zwrotne (lub cykliczne lub interaktywne) mogą mieć sygnały podróżujące w obu kierunkach poprzez wprowadzenie pętli w sieci. Sieci zwrotne są potężne i mogą się bardzo skomplikować. Obliczenia pochodzące z wcześniejszych danych wejściowych są przesyłane z powrotem do sieci, co daje im rodzaj pamięci. Sieci zwrotne są dynamiczne; ich „stan” zmienia się nieustannie, dopóki nie osiągną punktu równowagi. Pozostają w punkcie równowagi do momentu zmiany danych wejściowych i znalezienia nowej równowagi.

architektura sprzężenia zwrotnego

Sieci neuronowe ze sprzężeniem zwrotnym idealnie nadają się do modelowania relacji między zbiorem zmiennych predykcyjnych lub wejściowych a jedną lub większą liczbą zmiennych odpowiedzi lub danych wyjściowych. Innymi słowy, są one odpowiednie dla każdego problemu z mapowaniem funkcjonalnym, w którym chcemy wiedzieć, jak wiele zmiennych wejściowych wpływa na zmienną wyjściową. Wielowarstwowe sieci neuronowe ze sprzężeniem zwrotnym, zwane także wielowarstwowymi perceptronami (MLP), są najczęściej badanym i stosowanym modelem sieci neuronowej w praktyce.

Jako przykład sieci opinii mogę przypomnieć sobie sieć Hopfielda . Głównym zastosowaniem sieci Hopfielda jest pamięć asocjacyjna. Pamięć asocjacyjna to urządzenie, które przyjmuje wzorzec wejściowy i generuje wyjście jako zapisany wzorzec, który jest najściślej powiązany z wejściem. Funkcja skojarzonej pamięci polega na przywołaniu odpowiedniego zapisanego wzorca, a następnie wygenerowaniu wyraźnej wersji wzorca na wyjściu. Sieci Hopfield są zwykle używane w przypadku problemów z wektorami wzorów binarnych, a wzór wejściowy może być hałaśliwą wersją jednego z przechowywanych wzorów. W sieci Hopfield przechowywane wzorce są kodowane jako wagi sieci.

Samoorganizujące się mapy Kohonena(SOM) reprezentuje inny typ sieci neuronowej, który jest wyraźnie różny od sprzężonych w przód sieci wielowarstwowych. W przeciwieństwie do szkolenia w sprzężeniu zwrotnym MLP, szkolenie lub uczenie się SOM jest często nazywane bez nadzoru, ponieważ nie są znane docelowe wyniki związane z każdym wzorcem wejściowym w SOM, a podczas procesu szkoleniowego SOM przetwarza wzorce wejściowe i uczy się grupować lub segmentować dane poprzez dostosowanie wag (co czyni go ważnym modelem sieci neuronowej dla redukcji wymiarów i grupowania danych). Dwuwymiarowa mapa jest zwykle tworzona w taki sposób, że zachowane są rzędy wzajemnych powiązań między danymi wejściowymi. Liczbę i skład klastrów można wizualnie określić na podstawie rozkładu wyjściowego generowanego przez proces szkolenia. Z tylko zmiennymi wejściowymi w próbce treningowej,

(Schematy pochodzą ze strony internetowej C463 / B551 Artificial Intelligence Dany Vrajitoru .)


2
Czy sieć przesyłania dalej, która iteracyjnie wykorzystuje swoje wyjścia jako dane wejściowe, liczy się jako sieć cykliczna?
— naught101

1
Tak, rzeczywiście tak jest.
— bayerj

2
Mój poprzedni komentarz był błędny. Część tego postu została najwyraźniej plagiatowana przez tę osobę (pomijając kilka drobnych zmian słów) bez uznania.
— Glen_b

1
Próbuję matematycznie zrozumieć, dlaczego RNN są lepsze od sieci przesyłania dalej. Czy są jakieś przykłady, w których bardzo trudno jest oszacować przybliżenie za pomocą ANN, ale jest to łatwe z RNN.
— pikachuchameleon

14

To, co pisze George Dontas, jest poprawne, jednak wykorzystanie RNN w praktyce jest obecnie ograniczone do prostszej klasy problemów: szeregów czasowych / zadań sekwencyjnych.

Podczas sieci wyprzedzającym stosuje się nauczyć zestawów danych, takich jak , gdzie i są wektory (na przykład , sieci nawrotowych zawsze będzie sekwencji, na przykład .(i,t)iti∈Rnii∈(Rn)∗

Wykazano, że RNN mogą reprezentować dowolną mierzalną sekwencję do mapowania sekwencji przez Hammer.

Tak więc RNN są obecnie używane do wszelkiego rodzaju zadań sekwencyjnych: przewidywanie szeregów czasowych, znakowanie sekwencji, klasyfikacja sekwencji itp. Dobry przegląd można znaleźć na stronie Schmidhubera o RNN .


„Podczas gdy sieci sprzężenia zwrotnego są wykorzystywane do uczenia się zbiorów danych, takich jak (i, t), gdzie i it są wektorami (np. I∈Rn, dla sieci rekurencyjnych zawsze będę sekwencją, np. I∈ (Rn) ∗” Wiem, że to pytanie było zapytałeś dawno temu, ale czy mógłbyś wyjaśnić, co to oznacza w kategoriach laika? Muszę uzasadnić powód, dla którego zdecydowałem się na użycie sieci przesyłania dalej przez RNN w moim projekcie i myślę, że może to być powód. I / A może mógłbyś połączyć mnie ze źródłem, które pozwoli mi dokonać takiego uzasadnienia? Po przeszukaniu sam nie mogę znaleźć takiego. Dzięki, każda odpowiedź jest bardzo mile
— widziana

Ta odpowiedź jest teraz trochę przestarzała. Chociaż RNN w naturalny sposób nadają się do sekwencjonowania danych, mogą być również wykorzystywane do prognozowania danych statycznych (takich jak obrazy lub w inny sposób). Patrz: Rekurencyjna konwolucyjna sieć neuronowa do rozpoznawania obiektów i dowód, że obwody rekurencyjne mają krytyczne znaczenie dla wykonywania przez brzuszny strumień podstawowych zachowań związanych z rozpoznawaniem obiektów
— Firebug

1

Co jest naprawdę interesujące w zadawaniu tego pytania?

Zamiast mówić RNN i FNN ma inną nazwę. Więc są różne. , Myślę, że bardziej interesujące jest modelowanie układu dynamicznego, czy RNN różni się znacznie od FNN?

tło

Odbyła się debata na temat modelowania układu dynamicznego między Rekurencyjną siecią neuronową a siecią neuronową Feedforward z dodatkowymi funkcjami jak wcześniejsze opóźnienia czasowe (FNN-TD).

Z mojej wiedzy po przeczytaniu tych artykułów w latach 90-tych ~ 2010. Większość literatury woli, aby waniliowy RNN był lepszy niż FNN, ponieważ RNN korzysta z pamięci dynamicznej, podczas gdy FNN-TD jest pamięcią statyczną .

Jednak niewiele jest badań numerycznych porównujących te dwa. Ten [1] na początku pokazał, że do modelowania układu dynamicznego FNN-TD wykazuje porównywalną wydajność do waniliowego RNN, gdy jest wolny od szumów, a działa nieco gorzej, gdy występuje hałas. W moich doświadczeniach z modelowaniem układów dynamicznych często widzę, że FNN-TD jest wystarczająco dobry.

Jaka jest kluczowa różnica w traktowaniu efektów pamięci między RNN i FNN-TD?

Niestety nigdzie nie widzę, a żadna publikacja teoretycznie pokazuje różnicę między nimi. To dość interesujące. Rozważmy prosty przypadek, używając sekwencji skalarnej do przewidzenia . Jest to więc zadanie sekwencyjne do skalarnego.Xn,Xn−1,…,Xn−kXn+1

FNN-TD to najbardziej ogólny, kompleksowy sposób leczenia tak zwanych efektów pamięci . Ponieważ jest brutalny, obejmuje każdy rodzaj, każdy rodzaj, każdy efekt pamięci teoretycznie. Jedynym minusem jest to, że w praktyce zajmuje on zbyt wiele parametrów.

Pamięć w RNN jest niczym innym jak ogólnym „splotem” poprzednich informacji . Wszyscy wiemy, że splot między dwiema sekwencjami skalarnymi ogólnie nie jest procesem odwracalnym, a dekonwolucja jest najczęściej źle postawiona.

Moje przypuszczenie jest „stopień swobody” w takim procesie splotu zależy od liczby jednostek ukrytych w RNN państwowej . Jest to ważne dla niektórych układów dynamicznych. Zauważ, że „stopień swobody” może zostać przedłużony poprzez opóźnienie czasowe osadzania stanów [2] przy zachowaniu tej samej liczby jednostek ukrytych.s

Dlatego RNN faktycznie kompresuje poprzednią informację o pamięci z utratą przez wykonanie splotu, podczas gdy FNN-TD po prostu ujawnia je w pewnym sensie bez utraty informacji o pamięci. Pamiętaj, że możesz zmniejszyć utratę informacji w trakcie splotu, zwiększając liczbę ukrytych jednostek lub stosując więcej opóźnień czasowych niż waniliowy RNN. W tym sensie RNN jest bardziej elastyczny niż FNN-TD. RNN nie może osiągnąć żadnej utraty pamięci, ponieważ FNN-TD i może być trywialne pokazanie liczby parametrów w tej samej kolejności.

Wiem, że ktoś może chcieć wspomnieć, że RNN ma długotrwały efekt, podczas gdy FNN-TD nie. W tym celu chcę tylko wspomnieć, że dla ciągłego autonomicznego systemu dynamicznego, z teorii osadzania Takensa, jest to ogólna właściwość osadzania dla FNN-TD z pozornie krótką pamięcią czasu, aby osiągnąć taką samą wydajność jak pozornie długi czas pamięć w RNN. Wyjaśnia, dlaczego RNN i FNN-TD nie różnią się zbytnio przykładem ciągłego systemu dynamicznego na początku lat 90-tych.

Teraz wspomnę o zaletach RNN. Dla zadania autonomicznego układu dynamicznego, przy użyciu większej liczby poprzednich terminów, chociaż efektywnie byłoby to to samo, co przy użyciu FNN-TD z mniejszymi wcześniejszymi terminami w teorii, liczbowo byłoby pomocne, ponieważ jest bardziej odporny na zakłócenia. Wynik w [1] jest zgodny z tą opinią.

Odniesienie

[1] Gençay, Ramazan i Tung Liu. „Modelowanie i prognozowanie nieliniowe w sieciach feedforward i recurrent”. Physica D: Zjawiska nieliniowe 108.1-2 (1997): 119-134.

[2] Pan, Shaowu i Karthik Duraisamy. „Wykrywanie modeli zamknięcia oparte na danych”. nadruk arXiv arXiv: 1803.09318 (2018).
Korzystając z naszej strony potwierdzasz, że przeczytałeś(-aś) i rozumiesz nasze zasady używania plików cookie i zasady ochrony prywatności.
Licensed under cc by-sa 3.0 with attribution required.